在2026英特尔技术创新与产业生态大会上,英特尔展示了面向智能体AI需求构建的新一代智算中心方案。与传统智算中心主要关注模型训练和推理算力相比,这套方案把智能体实际完成任务的效率放到更重要的位置,并围绕CPU、GPU、网络和存储重新组织基础设施。
英特尔给出的核心判断是:智能体开始持续调用工具、创建运行环境、管理上下文并协调多项任务,智算中心需要同时处理推理、调度、数据供给和资源管理。CPU因此承担起更广泛的系统工作。英特尔从单颗至强处理器出发,进一步发布开放Agent整机柜平台规范,并联合合作伙伴推进KV Cache存储、词元一体机和模块化算力部署。
智能体把CPU推向系统中枢
智能体正在进入企业应用,英特尔在大会上援引的数据称:全球已有近80%的企业开始在内部尝试和导入智能体;到2031年,中国活跃的企业智能体预计将超过3.5亿个。随着智能体数量增长,基础设施面对的工作负载也在发生变化。
一次生成式AI请求通常以模型推理为主,智能体执行一项任务时,还需要拆解步骤、调用软件、访问数据,并为不同任务快速创建相互隔离的沙箱环境。GPU继续承担大规模并行计算,CPU则更多参与任务调度、逻辑处理、数据预处理和沙箱管理。衡量基础设施的方式,也从配置多少算力,延伸到既定电力和资源条件下能够稳定完成多少有效任务。
英特尔单颗至强6+处理器最高可支持超过1000个智能体稳定部署。在满足200毫秒启动时延服务等级协议的条件下,单颗至强6+处理器最多可支持350个沙箱并发创建,达到英特尔所选同类产品的1.46倍。相关结果来自英特尔测试,具体表现仍会受到工作负载、系统配置和软件环境影响。
企业同时部署大量智能体后,系统需要频繁创建、唤醒和回收运行环境。CPU既要提供通用计算能力,也要保证大量任务之间的隔离、调度和响应速度。单颗芯片解决基础性能,规模化部署进一步把问题推向整机柜。
从单颗芯片走向CPU整机柜
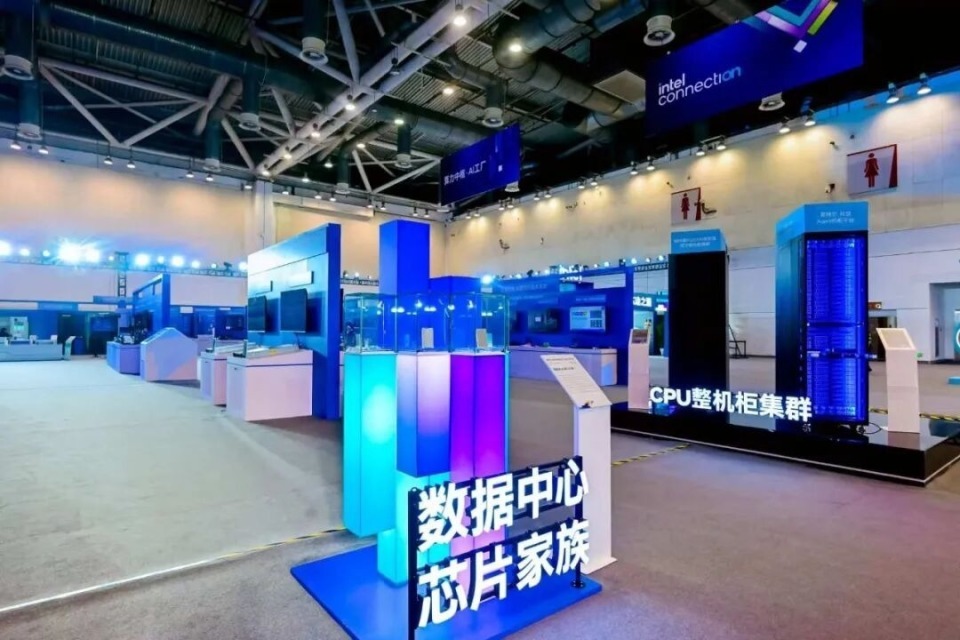
大会现场,英特尔联合产业伙伴发布英特尔开放Agent整机柜平台规范。该规范面向智能体大规模部署,将计算、内存、供电和散热纳入统一设计,使合作伙伴能够基于同一套规范开发整机柜产品。
整机柜的价值在于把单颗处理器的能力扩展为系统能力,当数据中心需要在短时间内拉起大量沙箱,处理器性能只是其中一部分,内存容量与带宽、节点间通信、供电和散热都会影响最终并发量和稳定性。开放规范为不同厂商提供共同的设计基础,也让整机柜可以根据智能体数量、任务类型和部署环境进行配置。
至强在智算中心中的角色也在继续扩大,在搭载GPU的AI服务器和集群中,至强可以作为机头CPU,负责数据预处理、任务协调、资源管理以及计算节点之间的连接。英特尔将CPU、GPU、以太网控制器和存储组合为系统级方案,并计划通过代号Crescent Island的数据中心GPU补充推理算力。
这套设计体现了英特尔对智能体基础设施的理解:GPU提供高密度并行计算,CPU负责通用计算和系统调度,网络与存储保证数据及时到达计算节点。智能体规模扩大后,几个环节需要按照同一项任务的节奏协同运行。
KV Cache让存储进入推理主链路
智能体处理长上下文并同时运行多个任务时,系统需要保存和反复调用大量KV Cache。它记录模型已经处理过的上下文状态,可以减少重复计算,也会持续占用内存和存储资源。随着上下文变长、并发数量增加,KV Cache的容量、传输速度和复用效率开始直接影响推理成本。
英特尔与合作伙伴提供G3.5创新存储方案,通过内存容量扩展和高性能共享KV Cache存储池,在容量、成本和性能之间进行平衡。英特尔还调用至强处理器内置的AMX、QAT等加速能力,推出KV Cache智能加速套件。根据客户验证结果,该套件可将KV Cache传输速率最高提升9.66倍,首字时延性能最高提升15倍。
围绕高性能AI存储,英特尔与焱融科技共同打造基于至强处理器的全闪存储系统。焱融全闪存储一体机F9000X Turbo采用至强6处理器,并利用MRDIMM提升内存带宽。该产品在MLPerf Storage v3.0基准测试中取得多项第一。
大会现场,英特尔与忆联还发布了面向智能体AI高效推理的分层KV Cache实践方案。方案以至强6处理器为核心,结合忆联UH812a企业级SSD,将不同访问频率的KV Cache放入相应的存储层级,在容量、性能和成本之间进行调度。
这些方案让存储从后台数据保存环节进入推理主链路,计算节点能否及时获得上下文数据,会直接影响GPU利用率和词元生成效率。至强在这里既承担计算任务,也参与数据压缩、传输和存储资源管理。
算力开始走向企业业务一线
英特尔还展示了两种面向实际部署环境的新思路,第一种是集装箱式AI算力仓,通过模块化设计缩短建设周期,并根据业务需求扩展算力规模。这类形态也便于靠近绿色能源部署,为大型数据中心提供更灵活的建设选择。
第二种是分布式和本地化部署,词元一体机把计算、存储、网络和软件环境集成到一个系统中,使AI算力从中央机房延伸到企业业务现场。英特尔TBX16词元一体机面向空间有限、噪声敏感的场景,在机柜参考设计中同时考虑散热效率和静音体验。
硬件部署之外,软件协同决定整套系统能否持续高效运行。供给侧需要提高KV Cache复用效率,减少重复计算;任务执行侧需要缩短沙箱冷启动、热启动和快照恢复时间。英特尔IAA、QAT、AMX等内置加速引擎分别参与数据压缩、计算卸载和矩阵运算,为词元生成和智能体运行提供加速。
从开放Agent整机柜到分层KV Cache,再到集装箱式算力仓和词元一体机,英特尔正在把至强处理器从服务器中的通用计算单元,推向智能体基础设施的调度和协同中枢。CPU、GPU、网络和存储围绕任务重新分工,也让智算中心的竞争从单点算力延伸到整个系统能够完成多少真实工作。
公赢网配资提示:文章来自网络,不代表本站观点。